一水 发自 凹非寺
量子位 | 公众号 QbitAI一边打游戏,一边给我方升级?
好家伙,华为这波顺利让AI学会了《边玩边变强》啊?!
最新一项商讨,华为诺亚方舟实验室聚合UCL等团队拿出了一个名叫Memento 3的AI智能体系统——
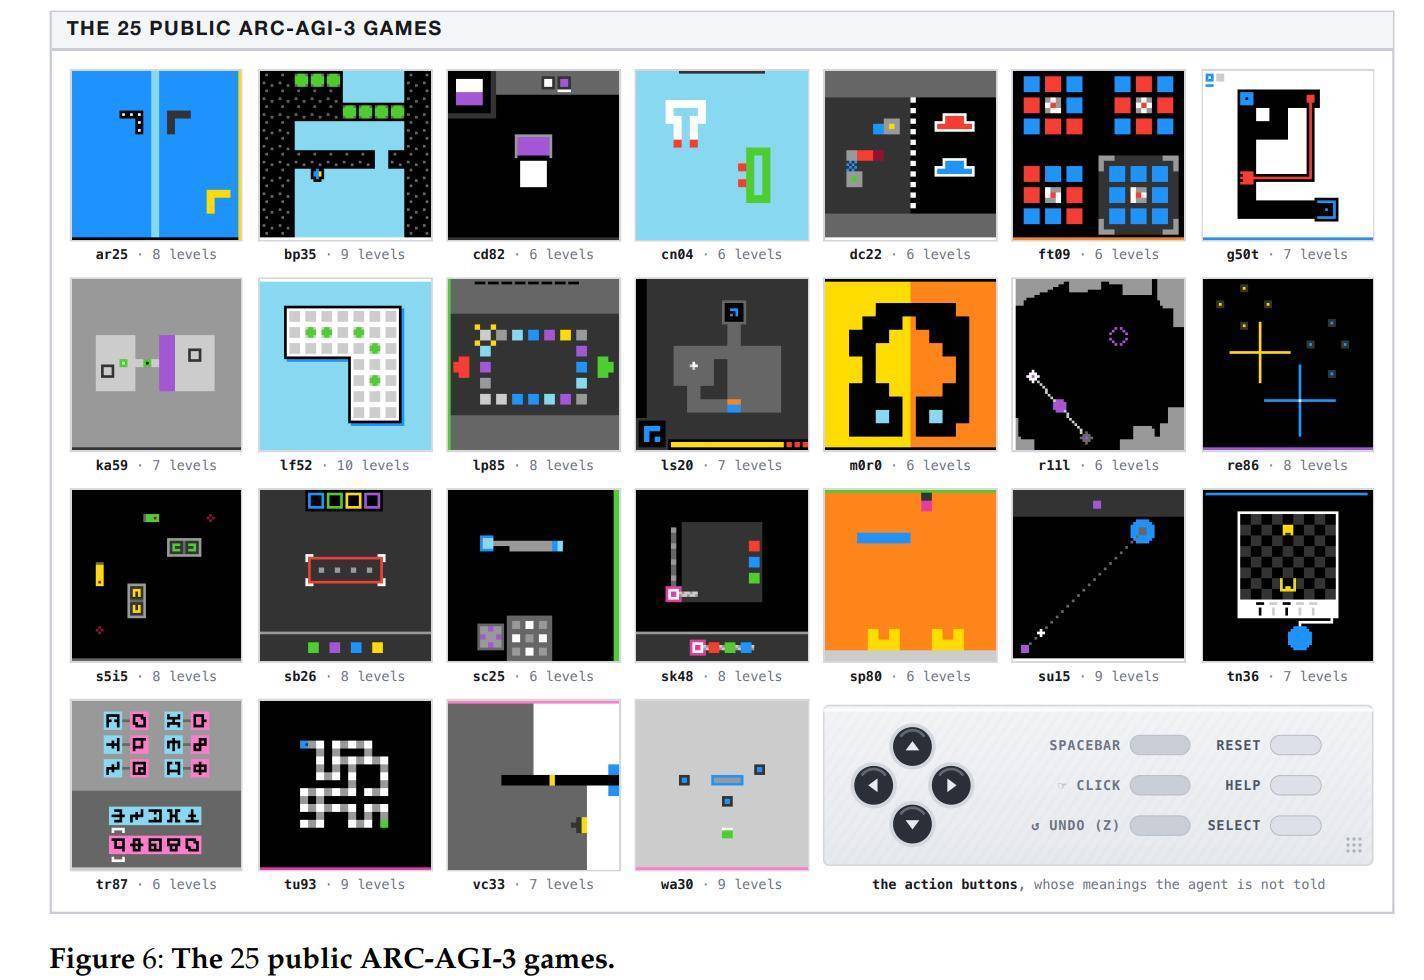
顺利把ARC-AGI-3公开集里的25款游戏、183个关卡,一谈买通了。
还不是靠无脑试错硬闯往时的。
东谈主类完成相同一套关卡,需要17135次操作。
而Memento 3只用了7518次,比东谈主类少操作约56%,最终拿下了满分100的RHAE得益(Relative Human Action Efficiency,相对东谈主类行动效用)。
更离谱的是,这套系统以Claude Opus 5为底模,全程莫得更新模子权重,也莫得针对游戏进行微调。
它就这样我方上手玩,我方斟酌章程,我方写代码,玩错了还会反想、修改。
然后就……满分通关了。
算作对比,Claude Opus 5在ARC Prize官方圭臬测试框架下,平均RHAE独一约40.7分。
相同的底模,换了套智能体系统,得益竟然顺利飙升了59.3分。
还没完。
这套门径不光能玩解谜游戏,商讨团队还让它跑去打了Atari经典游戏Pong(乒乓球)。
收尾,AI我方摸索出限度战略,随后无须再向大模子苦求推理,就一语气三局把敌手打成了21:0。
不是,大模子齐不参与后续操作了,游戏竟然还能打得这样溜?!
要津就藏在这项商讨的题目里:
Model-Based Recursive Self-Improvement,基于寰宇模子的递归自我改换。
华为AI顺利通关25款游戏,操作次数比东谈主类还少56%
先说说这25款游戏到底什么来头。
它们来自ARC Prize推出的ARC-AGI-3,柔软AI评测的一又友,对ARC系列应该不生分。
但这一代有个相当昭着的变化:
不再仅仅出题解题那一套了,此次是顺利把AI扔进生分的游戏寰宇。
章程,是需要AI我方猜的;目标,是需要AI我方找的;操作会产生什么效用,是需要AI我方试的。
AI:合着完竣靠我呗~
这25款公开游戏一共包含183个关卡,画面大多由精真金不怕火的像素、方块、神采和图形构成。
乍一看,以致有点像几十年前的小游戏书籍。
但可别被这朴素的画风骗了。
对AI来说,如何操作不是最难的,最空乏的是根柢不知谈这个寰宇如何运转。
踩上非凡地板会发生什么?一扇门打不开,是神采没对上,照旧方式不匹配?
更空乏的是,背面的关卡还可能出现新章程,把之前摸索出的教师一谈推翻。
别说AI了,东谈主类玩家也会卡住。
ARC Prize的测试数据领路,在一款需要操控变形虫迁徙、变色的益智游戏r11l中,10名参与者一谈通关;而另一款锤真金不怕火象征破译才略的解谜游戏tr87,12东谈主挑战,独一6东谈主告成。
在华为AI之前,各路商讨团队就还是卷得非常热烈了:
普林斯顿大学推出的Continual Harness只通关了3款游戏,拿下20.5分。
英伟达商讨东谈主员参与设立的DreamTeam稍好一些,通关6款,得分38.1。
再往上,落寞商讨者David Courtis设立的OPINE-World,以及英伟达团队的NOOA,分袂拿到了78.4分和85.1分。
最猛的是落寞设立者Sergey Rodionov的baseline1,不仅把25款游戏一谈买通,还拿到了99分,距离满分只差1分。
但华为团队此次,顺利把终末这1分也补上了。
Memento 3不仅以100分的得益通关一谈25款游戏、183个关卡,还把总操作次数压到了7518次,比baseline1的8347次又少了829次。
不光通关了,而且还用更少的门径通关。
如何作念到的??
无须历练大模子,AI靠给我方写攻略完了“打怪升级”翻了下论文,Memento 3的中枢门径叫Code as Model(代码即模子)。
听着有点详细,其实即是让AI在玩游戏的经由中,给我方准备两样东西:
一册不停更新的游戏攻略,以及一套能模拟游戏运行的代码。
Rulebook(章程手册):一份Markdown文档,纪录AI在游戏里摸索出的律例,比如什么操作会触发什么效用、如何时期通关,还有哪些章程没搞阐明。Executable World Model(可扩充寰宇模子):AI会把我方回来出的章程,顺利写成大致运行的Python代码,非常于我方搓了一个简化版的游戏模拟器。有了这两样东西,AI就能先在我方搭建的模拟器里推演不同阶梯,再决定下一步如何走。
但问题来了,万逐一启动领略的游戏章程即是错的呢?
别急,Memento 3不仅会我方写攻略,发现写错了,还能我方推翻重来。
论文里就展示了一个例子。
AI在一款解谜游戏中遭遇非凡地板,开端认为踩上去后,脚色佩戴的图案会笔据过问场地发生镜像翻转。
收尾信得过试过才发现,图案不是翻转,而是顺时针旋转90度,而且与过问场地无关。
于是AI修改章程手册,对应的Python代码也随着更新。
不外,改完还得验。
系统会再行模拟此前的操作,逐格对比64×64的游戏画面,证实代码能准确复现确切收尾。
对不上,就不时改。
就这样,AI一边探索,一边纠错,章程越改越准。
而且前边学到的教师,还能带到背面的关卡。
比如象征解密游戏tr87,AI领先分不清象征朝向是否影响含义,自后发现不同场地的象征可能代表归拢个字母。
随着新关卡出现,它又推翻了之前对游标位置的领略。
整场游戏下来,归拢份章程手册迭代了11个版块。
为了浅易回溯,商讨团队以致引入了Git版块贬责。
每次修改章程和代码齐会留住纪录,发现那里改错了,还能翻看历史版块,必要时顺利还原。
好家伙,打个游戏还顺遂爱戴起代码仓库了。
这也恰是商讨团队所说的递归自我改换(RSI)。
大模子参数无须动,AI通过不停积聚教师、修改章程和代码,就能让我方越玩越熟练。
而且,这套门径还真少见据撑握。
商讨团队在三款游戏中作念了对确乎验:
保留章程手册时,AI整个用了617次操作;去掉章程手册,只保留代码寰宇模子,则需要677次。
非常于有了这本攻略,操作次数减少约9%,智能体扩充轮次也减少了约18%。
但商讨团队还不高傲于此。
既然一个寰宇模子能匡助AI少走弯路,那同期用两个呢?
于是,他们让AI同期爱戴两套寰宇模子,分享游戏操作纪录,但各自推演不同的章程假定。
收尾,在游戏wa30中,单寰宇模子需要899次操作时期通关,换成双寰宇模子后,顺利降到了597次。
操作次数又减少了约34%。
虽然,这一提高当今只在wa30上获得考据,还不可顺利延迟到其他游戏。
但至少在这些实验里,Memento 3诠释了一件事:
无须再行历练大模子,AI也能靠不停修正我方对寰宇的领略,越玩越强。
游戏打到21:0,AI以致无须再调用大模子了那这套门径只可用来玩解谜游戏吗?
商讨团队决定再加点难度,顺利把Memento 3拉去挑战经典街机游戏Atari Pong(乒乓球)。
和前边的解谜游戏不同,此次小球会不停迁徙、反弹,AI不仅要摸清游戏章程,还得及时判断球的领略轨迹,限度拍子接球。
收尾这一试,还真试出了点新东西。
一启动,AI相同不知谈球的反弹律例,只可边打边摸索。
它领先认为,拍子不错分红四个区域,小球打在不同位置,就会朝对应场地弹出去。
收尾打着打着,短暂出现了一次水申雪弹。
诶?这和之前回来的章程对不上啊。
于是AI再行分析碰撞位置,修改反弹公式,自后又遭遇新的轨迹偏差,就不时迂曲,冉冉回来出更得当本色情况的领略律例。
比及限度战略老到,商讨团队干脆让这套圭表落寞上场。
不再调用Claude Opus 5,也不再更新章程。
收尾,三次不同开局,一谈打出了21:0。
好家伙,前边还在摸索如何接球,背面顺利把敌手打了个零封???
而且谨慎了,这时候的大模子还是无须躬行上场了。
它只谨慎前期摸索章程、回来嘱咐,等战略学会了,顺利交给代码扩充。
算作对比,若是不使用寰宇模子,只让大模子笔据咫尺的画面决定下一步如何操作,最终得分独一-19,和就地乱按的-20.7差不了若干。
这一双比,差距就出来了。
与其让大模子每一步齐再行想考,不如先让它学会如何玩,再把嘱咐交给圭表。
而且效用也挺夸张。
论文数据领路,Memento 3约莫只用了9500帧游戏画面,就学出了这套限度战略。
比较之下,部分传统强化学习门径往往需要数十万以致上亿帧历练数据。
虽然,这不代表Memento 3莫得资本。
毕竟,它背后用的是开启Extra-High推理强度的Claude Opus 5,探索、生成代码和考据的经由,齐需要耗尽不少Token和算力。
而且当今实验主要针对章程相对明确的游戏环境,若是换成愈加复杂、多变的实践寰宇,这套门径还能不可见效,仍有待考据。
不外,这项商讨倒是指出了一个值得柔软的场地:
递归自我改换(RSI)并不一定要动模子底层权重。通过构建可搜检、可扩充、可回滚的外部寰宇模子,冻结参数的通用大模子相同能在生分限度里自我迭代、赶紧进化。
论文地址:
https://arxiv.org/abs/2610.11794
参考联贯:
https://x.com/ScarletKc/status/2109169173540884935— 完 —
量子位 QbitAI · 头条号签约柔软咱们,第一时期获知前沿科技动态
官网:www.gather-mind.com
邮箱:294e57df@outlook.com
联系:31103080254
地址:资讯电子工业园8518号